Алгоритмы сортировки

117 задачвместе с подтемами
Число у задачи — рейтинг сложности, слово рядом — насколько она трудна по сравнению с другими задачами такого же типа. Шкалы задач с ответом и задач с кодом между собой не сравниваются. Рядом — счётчики попыток: успешные, неуспешные.
В библиотеке произошёл полтергейст! Книги на полке перепутались.  Библиотекарь хочет узнать, насколько сильно книги перепутаны.

Мера хаоса - это количество ИНВЕРСИЙ. Инверсия - это пара книг (i, j), где i < j, но книга i должна стоять ПОСЛЕ книги j (то есть номер книги i больше номера книги j).

Каждая книга имеет уникальный номер от 1 до N. Идеальный порядок: 1, 2, 3, ..., N.

Помогите библиотекарю подсчитать количество инверсий!

ВХОДНЫЕ ДАННЫЕ:
Первая строка: число N (1 ≤ N ≤ 100000) - количество книг.
Вторая строка: перестановка чисел от 1 до N - текущий порядок книг на полке.

ВЫХОДНЫЕ ДАННЫЕ:
Одно число - количество инверсий.
 
В программе Microsoft Excel имеется возможность сортировки таблицы по значениям какого-нибудь столбца. В процессе сортировки переставляются целиком строки таблицы (а не только значения в столбце, по которому осуществляется сортировка). При этом используется устойчивая сортировка, то есть если в этом столбце в нескольких строках стоят одинаковые значения, то эти строки после сортировки будут расположены в том же порядке, что и до сортировки (т.е. раньше будет идти та строка, которая до сортировки шла раньше).

Вася последовательно сортировал всю таблицу несколько раз. Вам дана последовательность номеров столбцов, по которым Вася сортировал таблицу — в этой последовательности один и тот же столбец мог встречаться несколько раз, например, если Вася отсортировал ее сначала по 1-му столбцу, потом по 2-му, а затем снова по 1-му.

Вам требуется написать программу, которая определит, можно ли было как-то оптимизировать последовательность сортировок так, чтобы результат не изменился (независимо от содержания таблицы). Например, если последовательность состоит из двух сортировок по столбцу 1, то можно оставить только одну такую сортировку.

Входные данные
В первой строке вводится одно число N – количество сортировок, которые сделал Вася (1 ≤ N ≤ 106).  Во второй строке содержатся N натуральных чисел, не превосходящих 105 – номера столбцов, по которым осуществлялась сортировка, в том порядке, в котором Вася это делал. Среди чисел могут быть равные.

Выходные данные
В первую строку  выведите одно число – минимальное количество сортировок, которые требуется произвести. Во второй строке требуется вывести номера столбцов, по которым нужно осуществлять сортировку, в том порядке, в котором следует проводить сортировки.
Вася нарисовал выпуклый N-угольник и провел в нем несколько диагоналей таким образом, что никакие две диагонали не пересекаются внутри N-угольника. Теперь он утверждает, что весь N-угольник оказался разбит на треугольники. Напишите программу, которая проверяет истинность Васиного утверждения.

Входные данные
Сначала вводятся числа N - количество вершин N-угольника (3 <= N <= 1000) и M - количество диагоналей, проведенных Васей. Далее на вход программы поступают M пар чисел, задающих диагонали (каждая диагональ задается парой номеров вершин, которые она соединяет). Гарантируется, что каждая пара чисел задает диагональ (то есть две вершины различны и не являются соседними), а также что никакие две пары не задают одну и ту же диагональ. Никакие две диагонали не пересекаются внутри N-угольника. Вершины N-угольника нумеруются числами от 1 до N.

Выходные данные
Если Васино утверждение верно, то программа должна выводить единственное число 0. В противном случае необходимо вывести сначала число K - количество вершин в какой-нибудь не треугольной части. Далее должно быть выведено K чисел - номера вершин исходного N-угольника, которые являются вершинами этой K-угольной части в порядке обхода этой части.
Фирма Macrohard получила заказ от армии одной страны на реализацию комплекса программного обеспечения для нового суперсекретного радара. Одной из наиболее важных подпрограмм в разрабатываемом комплексе является процедура сортировки.

Однако в отличие от обычной сортировки, эта процедура должна сортировать не произвольный массив чисел, который передается ей на вход, а специальный заранее заданный массив из N чисел, в котором записана некоторая фиксированная перестановка чисел от 1 до N, и кроме того, ни одно число в нем изначально не находится на своем месте (то есть на позиции с номером i изначально не находится число i).

В связи с повышенными требованиями к надежности комплекса в процессе сортировки разрешается выполнять единственную операцию - менять местами два соседних элемента массива. Кроме того, в связи с необходимостью соответствия уставу, не разрешается изменять положение числа, которое уже находится на своем месте.

Например, если массив из 6 элементов в некоторый момент имеет вид <2, 1, 3, 6, 4, 5>, то можно поменять местами 1 и 2, 6 и 4 или 4 и 5, а менять местами 1 и 3 или 3 и 6 нельзя, поскольку число 3 находится на своем месте (на позиции с номером 3).

Вам дан входной массив и поставлено важное задание. Найти последовательность обменов (не обязательно кратчайшую), сортирующую массив и удовлетворяющую приведенным условиям.

Подсказка

Найти такую последовательность обменов всегда возможно.

Входные данные
В первой строке вводится целое число N - размер входного массива (1 <= N <= 100). Вторая строка содержит N целых чисел - исходную перестановку чисел от 1 до N в массиве. Изначально ни одно число не стоит на своем месте.

Выходные данные
Выведите K строк, где K - количество обменов в Вашей сортировке. На каждой строке выведите по два числа xi и yi, разделенных пробелом - позиции в массиве, числа на которых следует поменять местами на i-ом обмене. Помните, что должно выполняться условие |xi - yi| = 1 и что нельзя перемещать число, которое уже стоит на своем месте.

Пояснение к примеру
В приведенном примере массив последовательно имеет следующий вид:
исходный вид массива
2 3 1 6 4 5
поменяли местами числа на 2 и 3 позициях
2 1 3 6 4 5
поменяли местами числа на 1 и 2 позициях
1 2 3 6 4 5
поменяли местами числа на 4 и 5 позициях
1 2 3 4 6 5
поменяли местами числа на 5 и 6 позициях
1 2 3 4 5 6
Громозека имеет последовательность целых чисел A длины N. Он свободно выбирает целое число b. Здесь ему станет грустно, если Ai и b+i находятся далеко друг от друга. Точнее, печаль Громозеки рассчитывается следующим образом:
\(abs(A_1-(b+1))+abs(A_2-(b+2))+...+abs(A_N-(b+N))\).
Здесь \(abs(x) \)- это функция, которая возвращает абсолютное значение x. Найдите минимально возможную печаль Громозеки.

Входные данные
В первой строке записано целое число N  (\(1<=N<=2 \cdot 10^5\)). Во второй строке записано N целых чисел Ai (\(1<=A_i<=10^9\)).

Выходные данные
Выведите на экран минимально возможную печаль Громозеки.
 
Примеры
Входные данные Выходные данные Пояснение
1 5
2 2 3 5 5
2 Если мы выберем b = 0, печаль Громозеки будет \(\) 
abs (2- (0 + 1)) + abs (2-(0 + 2))+ abs (3-(0 + 3)) + abs (5- (0 + 4)) + abs(5-(0 + 5)) = 2.
Любой другой выбор b не делает печаль Громозеки меньше 2, поэтому ответ - 2.
2 9
1 2 3 4 5 6 7 8 9
0  
3 6
6 5 4 3 2 1
18  
4 7
1 1 1 1 2 3 4
6  

Аркадий Аркадьевич, широко известный в узких кругах инженер, после выхода на пенсию решил отдохнуть и заняться садоводством. Он уже купил себе участок и собирается сажать там различные овощи и фрукты. Но всем известно, что растения должны расти в грядках, поэтому сейчас Аркадий Аркадьевич занят их сооружением.

Для того чтобы собрать прямоугольную грядку, нужны 4 доски. В идеале это должны быть две пары досок равной длины, тогда из них можно сложить ровный прямоугольник. Но если доски имеют неравную длину, то в одном из углов полученной грядки можно разместить пластиковый уголок: две планки длины \(r\), скреплённые под прямым углом. Уголок со стороной \(r\) позволит увеличить длины двух досок на величину, не превосходящую \(r\). Если противоположными сторонами грядки будут доски длины \(a\) и \(b\), а также \(c\) и \(d\) соответственно, то для того чтобы сделать прямоугольную грядку из этих досок, понадобится уголок размера \(\max(|a-b|, |c-d|)\) . Например, чтобы сделать грядку из досок длины 5, 7, 3, 2, понадобится уголок размера 2. На рисунке чёрным цветом изображены доски и красным цветом изображён уголок.
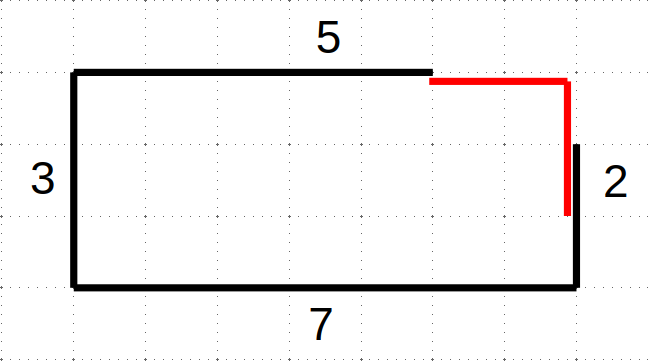
image

В сарае у Аркадия Аркадьевича нашлись \(n\) досок, \(i\)-я из которых имеет длину \(l_i\). Теперь он хочет выбрать из них четыре и сложить из них грядку таким образом, чтобы использовать уголок наименьшего размера. Помогите ему.

Первая строка входных данных содержит число \(n\) (\(4 \leq n \leq 10^5\)) — количество досок в сарае у Аркадия Аркадьевича.

Следующие \(n\) строк содержат числа \(l_1, \dots, l_n\) (\(1 \leq l_i \leq 10^9\)) — длины досок.

Программа должна сначала вывести число \(r\) — минимально возможный размер уголка.

Во второй строке выведите 4 числа \(a\), \(b\), \(c\), \(d\)  — длины досок, которые необходимо выбрать для грядки. При этом противоположными сторонами прямоугольника будут доски \(a\) и \(b\), а также \(c\) и \(d\). Если есть разные варианты выбора досок для грядки с одной и той же величиной уголка, можно вывести любой из них.

Решения, правильно работающие, когда \(n \leq 30\), будут оцениваться в 20 баллов.

Решения, правильно работающие, когда \(n \leq 100\), будут оцениваться в 45 баллов.

Решения, правильно работающие, когда \(n \leq 500\), будут оцениваться в 65 баллов.

Решения, правильно работающие, когда все \(l_i \leq 30\), будут оцениваться в 10 баллов.

На числовой прямой даны \(n\) отрезков. Нужно выбрать минимальное количество точек на прямой так, чтобы каждый отрезок содержал хотя бы одну из выбранных точек.

Точка \(x\) принадлежит отрезку \([l, r]\), если \(l \le x \le r\) (концы включены).

Формат входных данных

В первой строке — целое число \(n\) (\(1 \le n \le 10^5\)).

В каждой из следующих \(n\) строк — два целых числа \(l_i\) и \(r_i\) (\(-10^9 \le l_i \le r_i \le 10^9\)) — концы очередного отрезка.

Формат выходных данных

Одно целое число — минимальное количество точек.

Примечание

В первом примере четыре отрезка: \([1, 6]\), \([2, 8]\), \([7, 12]\), \([10, 16]\). Точки \(x = 6\) и \(x = 10\) вместе попадают в каждый из отрезков: \(6\) — в первые два, \(10\) — в последние два. Меньше двух точек не хватит — отрезки \([1, 6]\) и \([10, 16]\) не пересекаются, одной общей точки у них нет.

Во втором примере все три отрезка содержат точку \(x = 5\), так что одной точки достаточно.

На числовой прямой даны \(n\) отрезков. Для каждой неупорядоченной пары отрезков \((i, j)\) рассмотрим длину их пересечения. Если отрезки не пересекаются — длина пересечения равна нулю.

Найдите сумму длин пересечений по всем парам.

Формат входных данных

В первой строке — целое число \(n\) (\(1 \le n \le 10^5\)).

В каждой из следующих \(n\) строк — два целых числа \(l_i\) и \(r_i\) (\(-10^9 \le l_i \le r_i \le 10^9\)) — концы очередного отрезка.

Формат выходных данных

Одно целое число — сумма длин пересечений по всем неупорядоченным парам отрезков. Ответ может не помещаться в 32-битный тип.

Примечание

В первом примере три отрезка: \([0, 10]\), \([2, 6]\), \([8, 15]\).

  • Пересечение первого и второго — \([2, 6]\) длины \(4\).
  • Пересечение первого и третьего — \([8, 10]\) длины \(2\).
  • Пересечение второго и третьего пусто.

Сумма: \(4 + 2 + 0 = 6\).

Во втором примере четыре одинаковых отрезка длины \(10\). Каждая из \(\binom{4}{2} = 6\) пар даёт пересечение длины \(10\), итого \(60\).

На числовой прямой даны \(n\) отрезков. Назовём глубиной отрезка \(i\) количество отрезков \(j\) (включая сам отрезок \(i\)), которые целиком его содержат: \(l_j \le l_i\) и \(r_i \le r_j\).

Найдите максимальную глубину среди всех данных отрезков.

Формат входных данных

В первой строке — целое число \(n\) (\(1 \le n \le 5000\)).

В каждой из следующих \(n\) строк — два целых числа \(l_i\) и \(r_i\) (\(-10^9 \le l_i \le r_i \le 10^9\)) — концы очередного отрезка.

Формат выходных данных

Одно целое число — максимальная глубина.

Примечание

В первом примере отрезок \([3, 4]\) содержится в \([2, 5]\), который, в свою очередь, содержится в \([1, 10]\). Глубина \([3, 4]\) равна \(3\): его содержат он сам, \([2, 5]\) и \([1, 10]\). Это максимум.

Во втором примере все три отрезка совпадают, и каждый «содержится» в каждом — глубина равна \(3\).

На числовой прямой даны \(n\) отрезков. Требуется разбить их на минимальное число групп так, чтобы внутри каждой группы любые два отрезка не пересекались. При этом стыковка концом-к-началу пересечением не считается: отрезки \([a, b]\) и \([b, c]\) могут попасть в одну группу.

Найдите минимальное возможное число групп.

Формат входных данных

В первой строке — целое число \(n\) (\(1 \le n \le 10^5\)).

В каждой из следующих \(n\) строк — два целых числа \(l_i\) и \(r_i\) (\(0 \le l_i < r_i \le 10^9\)) — концы очередного отрезка.

Формат выходных данных

Одно целое число — минимум групп.

Примечание

В первом примере отрезки \([0, 30]\), \([5, 10]\), \([15, 20]\), \([25, 35]\). В одну группу можно положить \([5, 10]\), \([15, 20]\) и \([25, 35]\) — они попарно не пересекаются. Отрезок \([0, 30]\) пересекается с каждым из них и требует отдельной группы. Итого: \(2\).

Во втором примере отрезки \([10, 20]\) и \([20, 30]\) стыкуются по точке \(20\), и по условию это не считается пересечением. Поэтому одной группы достаточно.

На числовой прямой задан целевой отрезок \([L, R]\) и \(n\) отрезков-«покрывал». Определите, покрывают ли эти \(n\) отрезков целевой отрезок целиком — то есть каждая точка из \([L, R]\) принадлежит хотя бы одному из них.

Формат входных данных

В первой строке — два целых числа \(L\) и \(R\) (\(-10^9 \le L \le R \le 10^9\)) — концы целевого отрезка.

Во второй строке — целое число \(n\) (\(1 \le n \le 10^5\)).

В каждой из следующих \(n\) строк — два целых числа \(l_i\) и \(r_i\) (\(-10^9 \le l_i \le r_i \le 10^9\)) — концы очередного отрезка-покрывала.

Формат выходных данных

Выведите YES, если каждая точка целевого отрезка \([L, R]\) покрыта хотя бы одним из данных отрезков, и NO иначе.

Примечание

В первом примере отрезки \([0, 4]\), \([3, 7]\), \([6, 10]\) вместе покрывают всю цель \([0, 10]\) без пропусков.

Во втором примере между точками \(4\) и \(6\) есть пропуск (точка \(5\) не покрыта ни одним отрезком), поэтому ответ NO.

На числовой прямой нарисованы \(n\) отрезков. Отрезки могут пересекаться, накладываться или совпадать. Точка прямой считается закрашенной, если она принадлежит хотя бы одному отрезку.

Найдите суммарную длину закрашенной части прямой.

Формат входных данных

В первой строке — целое число \(n\) (\(1 \le n \le 10^5\)).

В каждой из следующих \(n\) строк — два целых числа \(l_i\) и \(r_i\) (\(-10^9 \le l_i \le r_i \le 10^9\)) — концы очередного отрезка.

Формат выходных данных

Одно целое число — длина объединения всех данных отрезков.

Примечание

В первом примере отрезки \([1, 5]\) и \([3, 7]\) сливаются в один отрезок \([1, 7]\) длины \(6\). Отдельный отрезок \([10, 12]\) добавляет ещё \(2\). Итого: \(8\).

Во втором примере четыре отрезка стыкуются концом-к-началу и образуют один сплошной отрезок \([0, 4]\) длины \(4\).

На числовой прямой нарисованы \(n\) отрезков. Концы отрезков заданы целыми числами. Точка \(x\) считается принадлежащей отрезку \([s, f]\), если \(s \le x \le f\) (концы включены).

Найдите такую целую точку \(x\), которой одновременно принадлежит максимальное количество данных отрезков. Если таких точек несколько, выведите наименьшую из них.

Формат входных данных

В первой строке записано целое число \(n\) (\(1 \le n \le 10^5\)) — количество отрезков.

В каждой из следующих \(n\) строк записаны два целых числа \(s_i\) и \(f_i\) (\(-10^9 \le s_i \le f_i \le 10^9\)) — концы очередного отрезка.

Формат выходных данных

Выведите два целых числа через пробел: максимальное количество отрезков, накрывающих одну точку, и наименьшую целую точку, в которой этот максимум достигается.

Примечание

В первом примере отрезки \([0,1]\), \([0,2]\), \([1,2]\). Точка \(x = 1\) принадлежит всем трём отрезкам, и это наименьшая такая точка.

Во втором примере точка \(x = 1\) принадлежит двум отрезкам: \([0,1]\) и \([1,3]\). Это максимум, достигаемый раньше всего на прямой.

Ночью на сибирской трассе одновременно сошло \(n\) снежных заносов. Каждый занос перекрывает участок дороги между километровыми отметками \(a_i\) и \(b_i\) включительно. Сообщения о заносах поступали диспетчеру по рации в произвольном порядке, поэтому \(a_i\) может оказаться как меньше, так и больше \(b_i\): занос покрывает все километровые отметки от \(\min(a_i, b_i)\) до \(\max(a_i, b_i)\) включительно.

К утру с трассы поступили \(m\) запросов от водителей. Каждый водитель называет километровую отметку \(p_j\), на которой он сейчас находится, и просит сообщить, сколько заносов перекрывают этот километр. Помогите диспетчеру быстро ответить на все запросы.

Формат входных данных

В первой строке записаны два целых числа \(n\) и \(m\) (\(1 \le n, m \le 50\,000\)) — количество заносов и количество запросов.

В следующих \(n\) строках записаны по два целых числа \(a_i\) и \(b_i\) (\(-10^9 \le a_i, b_i \le 10^9\)) — концы участка \(i\)-го заноса в произвольном порядке.

В последней строке через пробел записаны \(m\) целых чисел \(p_1, p_2, \ldots, p_m\) (\(-10^9 \le p_j \le 10^9\)) — километровые отметки, о которых спрашивают водители.

Формат выходных данных

Выведите \(m\) целых чисел через пробел: для каждой отметки \(p_j\) — количество заносов, перекрывающих этот километр.

Примечание

Точка считается принадлежащей участку с концами \(a\) и \(b\), если выполняется неравенство \(\min(a, b) \le p \le \max(a, b)\). Совпадение с границей засчитывается.

Два слова являются анаграммами, если одно можно получить из другого перестановкой букв.

На вход подаётся число \(N\), затем \(N\) слов (каждое с новой строки, все строчные).

Программа должна:

  • Разбить слова на группы анаграмм
  • Вывести каждую группу, в которой больше одного слова
  • Группы отсортировать по убыванию размера. При равном размере — по алфавиту первого слова
  • Слова внутри группы — в алфавитном порядке, через пробел

Формат входных данных

Первая строка — целое число \(N\) (\(1 \le N \le 30\)).

Следующие \(N\) строк — по одному слову (строчные русские буквы).

Формат выходных данных

Группы анаграмм (только те, где больше одного слова). Слова в группе через пробел в алфавитном порядке. Каждая группа на отдельной строке.

Два слова являются анаграммами, если одно можно получить из другого перестановкой букв.

На вход подаётся число \(N\), затем \(N\) слов (каждое с новой строки, все строчные).

Программа должна:

  • Разбить слова на группы анаграмм
  • Вывести каждую группу, в которой больше одного слова
  • Группы отсортировать по убыванию размера. При равном размере — по алфавиту первого слова
  • Слова внутри группы — в алфавитном порядке, через пробел

Формат входных данных

Первая строка — целое число \(N\) (\(1 \le N \le 30\)).

Следующие \(N\) строк — по одному слову (строчные русские буквы).

Формат выходных данных

Группы анаграмм (только те, где больше одного слова). Слова в группе через пробел в алфавитном порядке. Каждая группа на отдельной строке.

Два слова являются анаграммами, если одно можно получить из другого перестановкой букв. Например, «кот», «ток» и «кто» — это анаграммы друг друга.

На вход подаётся число \(N\), затем \(N\) слов (каждое с новой строки, все строчные).

Программа должна:

  • Разбить слова на группы анаграмм
  • Вывести каждую группу, в которой больше одного слова
  • Группы отсортировать по убыванию размера. При равном размере — по алфавиту первого слова
  • Слова внутри группы — в алфавитном порядке, через пробел

Формат входных данных

Первая строка — целое число \(N\) (\(1 \le N \le 30\)).

Следующие \(N\) строк — по одному слову (строчные русские буквы).

Формат выходных данных

Группы анаграмм (только те, где больше одного слова). Слова в группе через пробел в алфавитном порядке. Каждая группа на отдельной строке.

Примечание

Подсказка: два слова — анаграммы, если при сортировке их букв получается одинаковый результат. Например, sorted("кот") и sorted("ток") оба дают ['к', 'о', 'т'].

Учитель ведёт журнал сдачи домашних заданий. На вход подаётся число \(N\) — количество записей. Затем \(N\) строк в формате:

имя предмет балл

Один ученик может сдавать задания по разным предметам.

Программа должна для каждого ученика подсчитать количество сданных заданий и суммарный балл. Вывести таблицу, отсортированную по убыванию количества заданий. При равном количестве — по возрастанию суммы баллов. При полном равенстве — в алфавитном порядке.

Формат входных данных

Первая строка — целое число \(N\) (\(1 \le N \le 30\)).

Следующие \(N\) строк — имя, предмет и балл через пробел.

Формат выходных данных

Для каждого ученика строка в формате: Имя — X заданий, Y баллов

На соревнованиях по прыжкам в длину зафиксированы результаты спортсменов. На вход подаётся число \(N\) — количество спортсменов. Затем вводятся \(N\) целых чисел (каждое с новой строки) — дальность прыжка в сантиметрах.

Программа должна:

  • Собрать все числа в список
  • Отсортировать список по возрастанию
  • Вывести отсортированный список
  • Вывести три наибольших значения (последние 3 элемента отсортированного списка)

Формат входных данных

Первая строка — целое число \(N\) (\(3 \le N \le 20\)).

Следующие \(N\) строк — по одному целому числу (от 100 до 900).

Формат выходных данных

Первая строка — отсортированный список в формате [a, b, c, ...].

Вторая строка — три наибольших значения в формате Топ-3: [x, y, z].

Метеостанция записала температуру за несколько дней. На вход подаётся число \(N\) — количество дней. Затем вводятся \(N\) целых чисел (каждое с новой строки) — температура каждого дня.

Программа должна:

  • Собрать все числа в список
  • Отсортировать список по возрастанию
  • Вывести отсортированный список
  • Вывести три наибольших значения (последние 3 элемента отсортированного списка)

Формат входных данных

Первая строка — целое число \(N\) (\(3 \le N \le 20\)).

Следующие \(N\) строк — по одному целому числу (от \(-50\) до \(50\)).

Формат выходных данных

Первая строка — отсортированный список в формате [a, b, c, ...].

Вторая строка — три наибольших значения в формате Топ-3: [x, y, z].

Поделиться
Класснуть